Una IA que no redacta correos, no dibuja imágenes y no mantiene una conversación parece una propuesta extraña en 2026. Es, precisamente, lo que TypeSafe presentó el 15 de septiembre con Jev: un modelo para responder preguntas concretas que otros programas puedan convertir en acciones. La acogida inicial ha llamado la atención. Según los datos que Vercel publicó el 18 de septiembre, casi el 13 % de los equipos de pago de su AI Gateway usaron Jev durante sus primeras 24 horas en ese servicio: el mejor arranque de un modelo allí. Ese dato describe a los clientes de Vercel durante un día, no a todo el mercado de la IA.
La idea importa porque muchas tareas automatizadas no necesitan otro párrafo generado. Necesitan decidir si un mensaje va a ventas o soporte, si un agente puede ejecutar una herramienta, o si una incidencia debe pasar a una persona. TypeSafe quiere que Jev se encargue de esas decisiones mientras el programa conserva el control sobre lo que sucede después.
Qué es Jev y qué hace de forma distinta
Diogo Almeida, fundador de TypeSafe y antiguo investigador de OpenAI, presentó Jev como el primer modelo de la familia «System One». Se le envía un estado —por ejemplo, el contenido de una solicitud de ayuda— y una o varias preguntas con respuestas definidas de antemano. El sistema devuelve valores que el software puede leer directamente, acompañados de probabilidades.
La documentación de TypeSafe distingue tres tipos de pregunta. Choice elige entre opciones, como «facturación», «cuenta» o «problema técnico». Score valora un caso en una escala previamente fijada. Noul devuelve una probabilidad para una pregunta de sí o no. Se pueden enviar varias en una misma petición. Así, una aplicación podría clasificar una reclamación, estimar su urgencia y decidir si requiere revisión humana sin pedirle al modelo que escriba una explicación completa.
La diferencia con un chatbot no consiste en que los modelos generales sean incapaces de devolver datos estructurados. También pueden hacerlo. La apuesta de TypeSafe es entrenar y diseñar toda la interfaz alrededor de decisiones acotadas, evaluadas en paralelo, en vez de generar una respuesta palabra por palabra. Eso tiene una consecuencia clara: Jev no sirve para redactar la contestación al cliente. Hace falta otro modelo o una plantilla para escribirla.
De elegir un clic a frenar una acción arriesgada
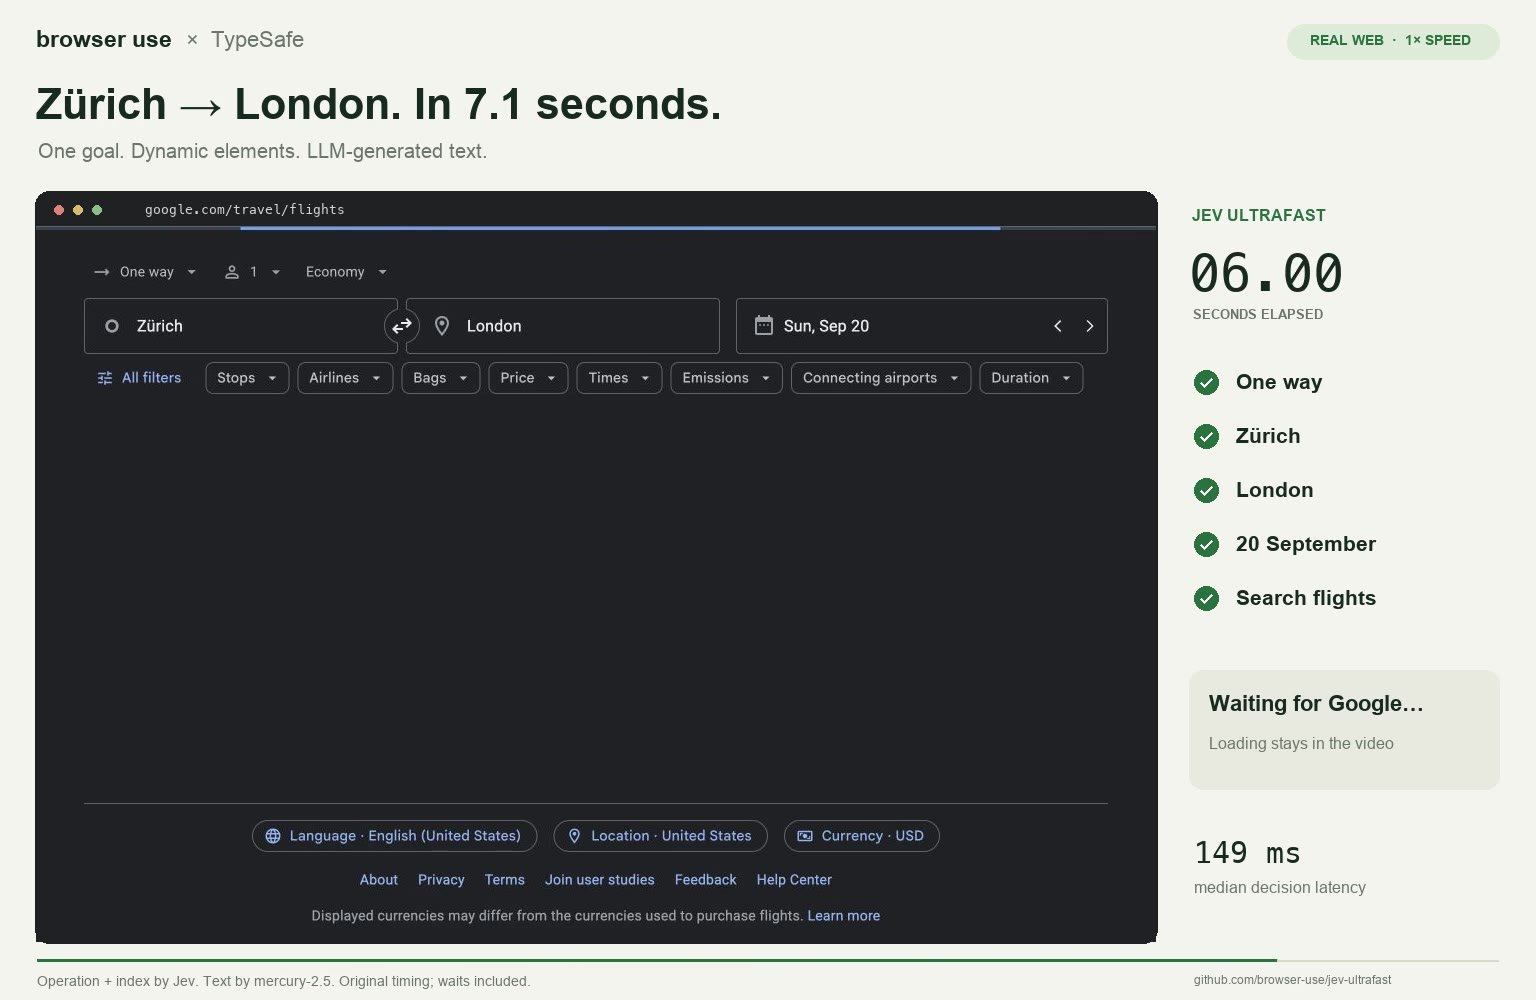
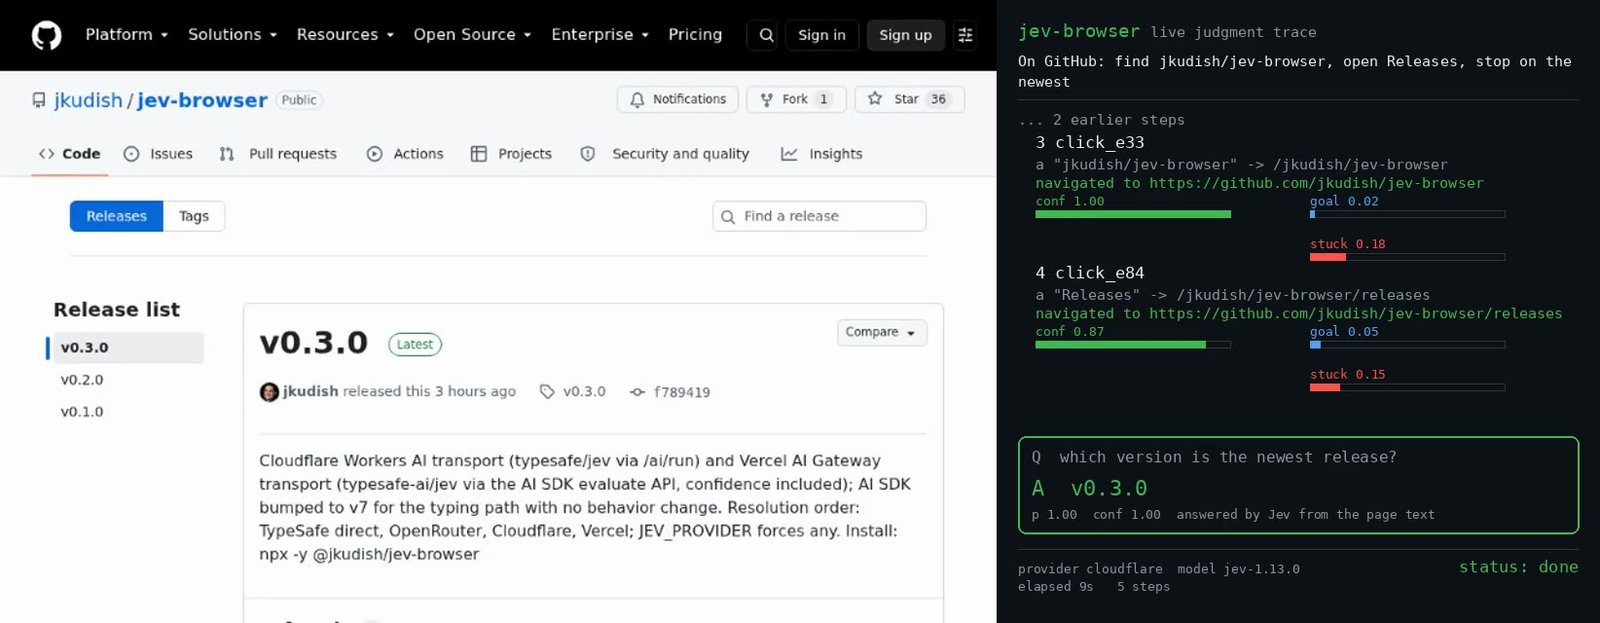
Ya hay desarrolladores probando esa idea fuera de las demostraciones de TypeSafe. Browser Use publicó una integración en la que Jev elige la siguiente operación y el elemento de una página web. Su vídeo muestra una búsqueda de vuelos de Zúrich a Londres en Google Flights. La grabación corresponde a una ejecución que sus autores describen como real, de unos siete segundos; otro modelo pequeño genera el texto cuando hay que escribir en un campo. Jev no «reserva» el vuelo ni realiza por sí solo toda la navegación. Otra integración, jev-browser, muestra la página y las probabilidades de las acciones que Jev considera antes de avanzar.
Otro proyecto, dsh-jev, coloca Jev ante algunas acciones de un agente que administra un entorno de Kubernetes. Su ejemplo presenta una incidencia tras una actualización: el agente encuentra una instrucción que propone abrir demasiado el acceso a una base de datos. En la secuencia publicada, la capa de decisiones bloquea ese atajo y permite continuar con una reparación más precisa. Los autores aclaran que el vídeo reproduce una secuencia registrada con evaluaciones reales; no muestra al agente improvisando en directo. También documentan un falso positivo: Jev rechazó una acción inocua.
Son ejemplos de por qué interesa una IA que actúe como filtro o clasificador dentro de un programa. También muestran su límite: las reglas, los permisos, las confirmaciones y las acciones efectivas siguen estando en el código que rodea al modelo. Una probabilidad alta no debería convertirse automáticamente en permiso para cualquier operación.
¿Es realmente 193 veces más rápido y 444 veces más barato?
TypeSafe anuncia que Jev puede alcanzar 193,6 veces más velocidad y un coste hasta 444,6 veces menor que los modelos comparados en sus evaluaciones de flujos de trabajo. La compañía publica los cuatro casos y su método, centrados en decisiones dentro de procesos como atención al cliente, facturas e incidentes de seguridad. El propio lanzamiento reconoce que esos resultados probablemente estén en el extremo alto de las mejoras que cabe esperar en usos reales y que los flujos fueron diseñados por su equipo.
La comparación requiere además entender qué se mide. Los modelos reciben preguntas de respuesta acotada; las respuestas de referencia se construyen a partir del promedio de modelos grandes, no de una verdad independiente comprobada para todos los casos. El resultado es una prueba útil de la propuesta de TypeSafe, pero no demuestra que Jev sea cientos de veces mejor para cualquier tarea ni que sustituya a una IA general.
El precio publicado por TypeSafe es de 0,042 dólares por millón de tokens de entrada y sin cargo por tokens de salida. La compañía sitúa el tiempo de respuesta habitual de sus pruebas entre 70 y 500 milisegundos. Son tarifas y cifras comunicadas por el proveedor, sujetas a la forma de acceso y a las condiciones de cada plataforma. Lo decisivo para un equipo que quiera usarlo será medir precisión, coste y latencia con sus propios casos y con errores que realmente importen en su aplicación.
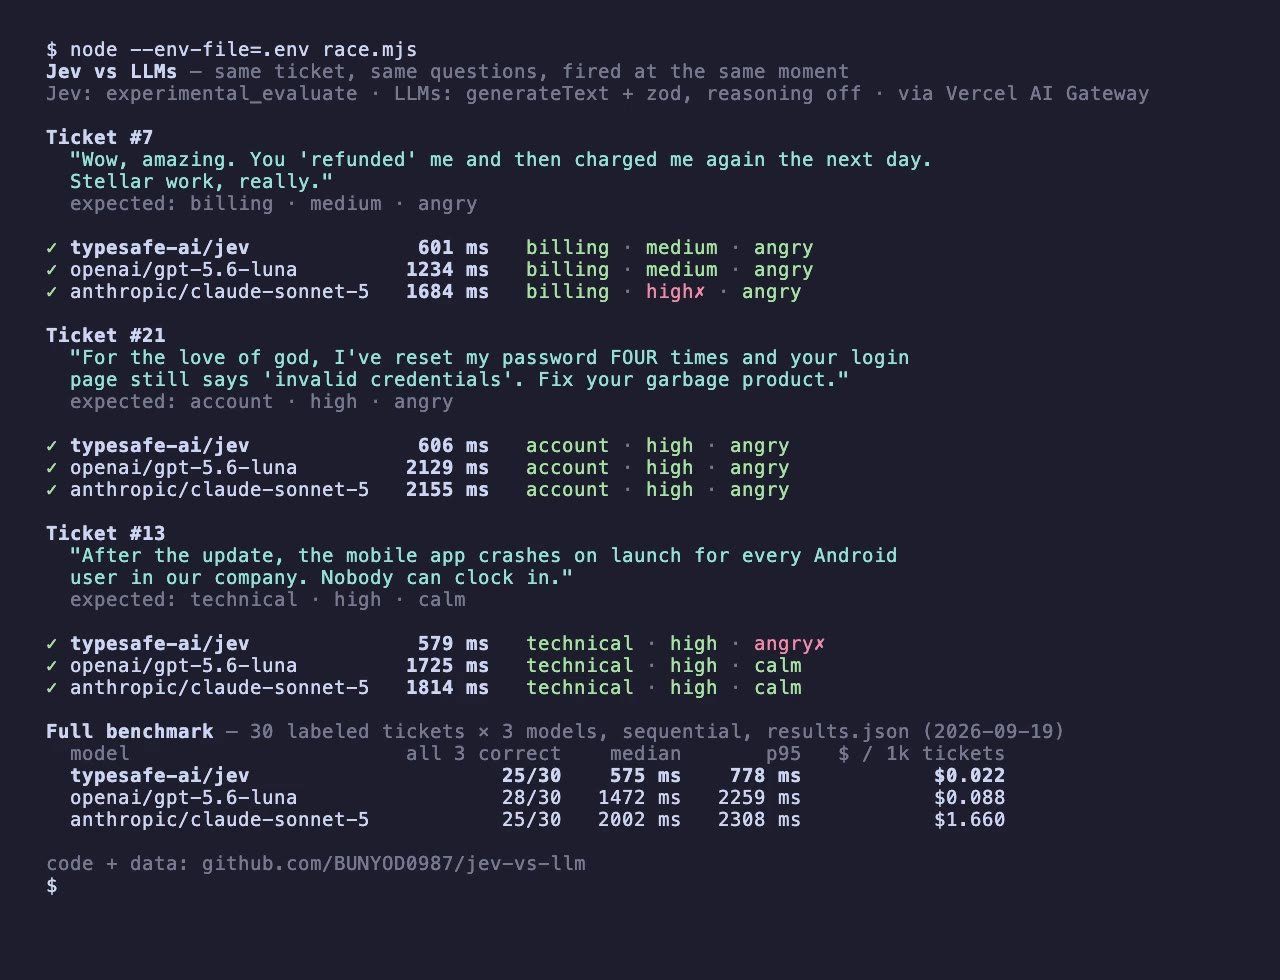
Una prueba pequeña publicada por un desarrollador ilustra ese equilibrio. En 30 solicitudes de ayuda etiquetadas, Jev resolvió las tres preguntas del ejercicio en 25 casos; GPT-5.6 Luna lo hizo en 28. Jev registró menos tiempo y un coste estimado menor por mil solicitudes en ese experimento. Son 30 casos de una sola tarea, no una comparación concluyente entre modelos, pero recuerdan que velocidad y acierto deben mirarse juntos.
«No alucina» no significa que siempre acierte
TypeSafe afirma que Jev no puede devolver un tipo de dato fuera de las opciones previstas: si se le pide una categoría de una lista, su respuesta conserva esa estructura. Es una garantía sobre el formato, no sobre la corrección de la decisión. Un ticket puede acabar en el departamento equivocado aunque el resultado sea perfectamente legible para el programa.
La empresa enumera en la guía de limitaciones de Jev 1.13 problemas con la aritmética, el recuento, la comparación de fechas, las instrucciones ambiguas y los textos que intentan manipular su respuesta. Recomienda dejar los cálculos exactos al código, hacer preguntas específicas y probar los casos difíciles antes de automatizarlos. En tareas delicadas, el programa debería reservar la revisión humana para respuestas inciertas y comprobar también qué ocurre si el modelo falla.
Por qué este lanzamiento merece atención
La reacción inicial sugiere que los desarrolladores buscaban una herramienta así. Vercel publicó que, en el primer día de Jev en su AI Gateway, lo usaron casi el 13 % de los equipos de pago, más del doble de los que habían probado cualquier lanzamiento anterior en ese mismo plazo. El dato no indica cuántas aplicaciones lo mantendrán ni mide su fiabilidad en producción. Sí señala un interés temprano por piezas de IA más específicas, diseñadas para trabajar dentro de otros sistemas.
Jev no pretende ser el asistente con el que habla una persona. Su apuesta es menos visible: decidir millones de pequeñas bifurcaciones entre una petición y la respuesta de una aplicación. Si esas decisiones resultan acertadas y baratas fuera de las demostraciones, podrían hacer más ágiles muchos servicios. Si se usan sin probar sus errores, la velocidad también puede multiplicar las equivocaciones. Ahí estará la prueba importante después del lanzamiento.
Créditos de las demostraciones: Browser Use, Jacob Kudish y BUNYOD0987, con licencia MIT.