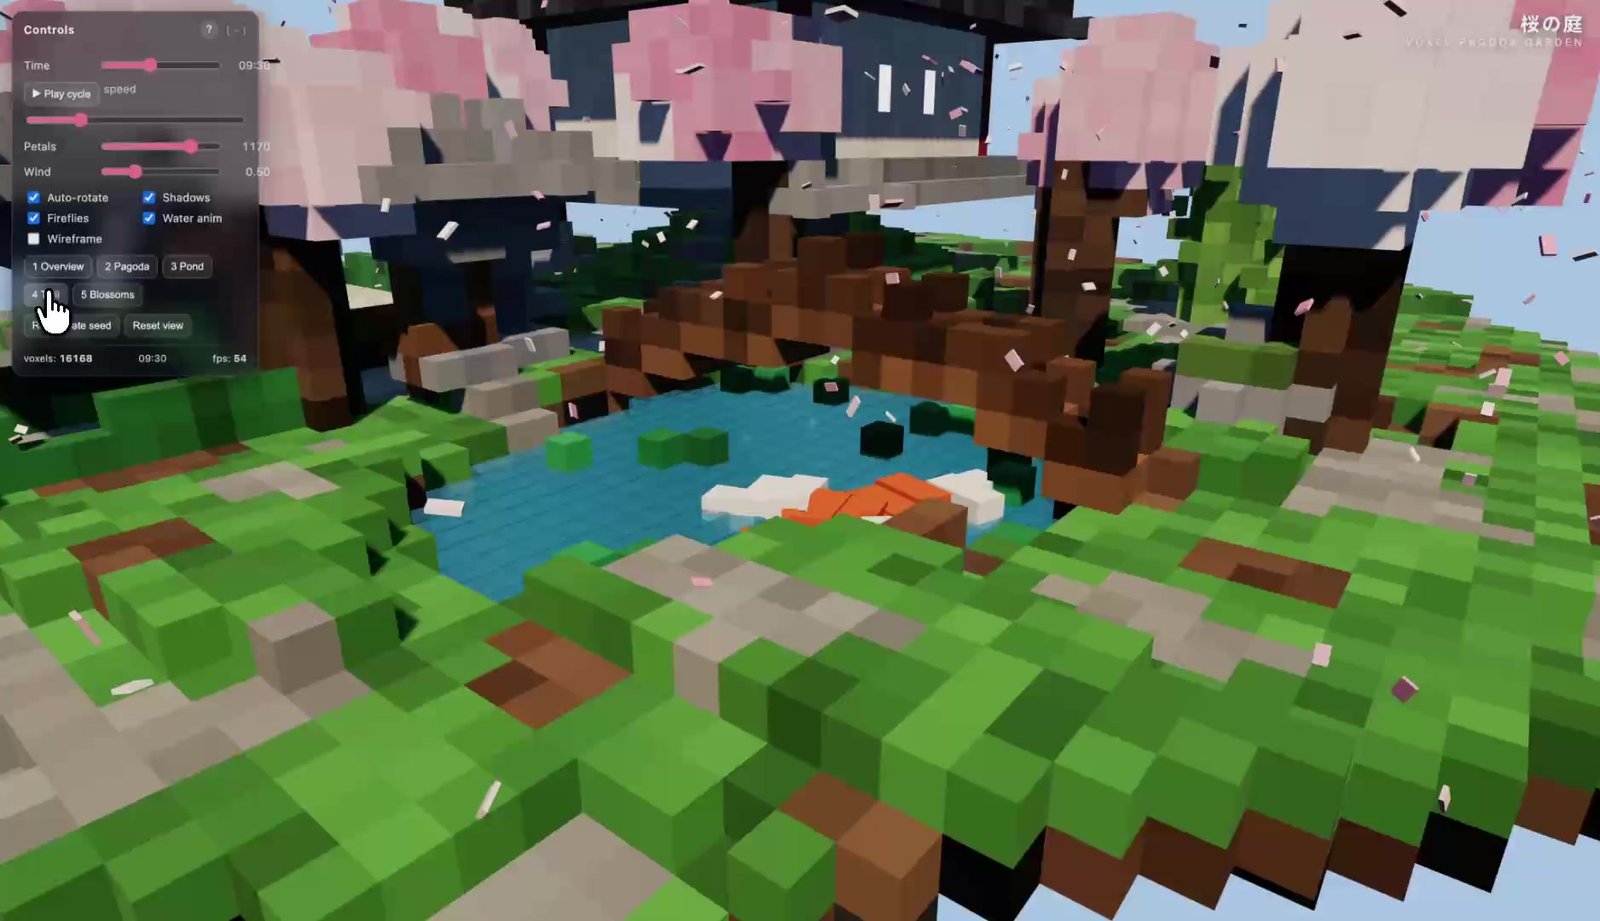
Un jardín japonés hecho de pequeños bloques, con peces, árboles y una pagoda que puedes explorar en el navegador. Es el resultado que muestra el creador de Strata, un proyecto abierto que permite ejecutar Qwen3.8-Flash-Next en un ordenador con una tarjeta gráfica de consumo. Su atractivo es práctico: usar un modelo grande para escribir código o conversar sin enviar cada petición a un proveedor de inferencia. La demostración del autor sirve para ver qué ha construido; no es una prueba de PLANA ni una garantía de que cualquier equipo conseguirá ese resultado.

El repositorio de Strata ganó visibilidad en Hacker News con una promesa llamativa sobre hardware doméstico. La última versión publicada que hemos comprobado es la 0.1.39, del 4 de octubre de 2026. La demo es anterior, del 27 de septiembre: no muestra una prueba de esa nueva versión. Estas son las capacidades y condiciones que documenta el proyecto a 5 de octubre.
Qué hace Strata y para qué puede servirte
Strata es el motor y la aplicación que ejecutan el modelo. Tiene chat en el navegador, un monitor del uso de recursos y conexiones compatibles con las API de OpenAI y Anthropic. Eso permite conectarlo con herramientas y agentes de programación compatibles. La compatibilidad de una API no significa que estés ejecutando el modelo privado de ChatGPT o Claude: el que responde es Qwen. El proyecto también admite imágenes, con diferencias según la plataforma. Funciones documentadas.
Para un desarrollador, la utilidad puede estar en trabajar con código usando un servidor local. La inferencia queda en el equipo, pero las aplicaciones conectadas pueden tener sus propias conexiones externas. Por eso, «local» no certifica por sí solo que todo un flujo con agentes, búsquedas o servicios sea privado. El coste también se desplaza: no hay una factura por cada petición a este motor, aunque siguen existiendo el hardware, la electricidad y el mantenimiento.

Cómo puede caber un modelo tan grande
Qwen describe un núcleo de 125.000 millones de parámetros, con 6.000 millones activos, además de una tabla de representaciones de 51.000 millones y un módulo de predicción de 4.000 millones. Es una arquitectura con expertos: no usa todo el modelo para cada paso. Ficha original de Qwen.
Strata reparte el trabajo entre la tarjeta gráfica, la RAM y el procesador. Mantiene en la GPU los expertos más utilizados, deja otros en RAM y consulta en disco una tabla grande. También usa un módulo que propone tokens y los comprueba con el modelo. Así aprovecha más componentes del PC; no convierte 12 GB de memoria gráfica en toda la memoria que necesita. Cómo funciona el motor.
GPU, RAM y SSD: qué necesitas realmente
La configuración habitual parte de una GPU NVIDIA RTX o AMD Radeon compatible con 12 GB de VRAM o más, Windows 10/11 o Linux, y un procesador x86-64 con AVX2. NVIDIA exige un controlador 580 o posterior. No basta con que una tarjeta tenga esa memoria: hay que comprobar el modelo en la lista de hardware admitido.
La guía de variantes distingue tres situaciones útiles. Con 32 GB de RAM, la opción habitual es Coder, especializada en programación; algunos modelos completos caben usando una GPU de 24 GB y el modo de poca RAM. Con 48 GB, propone Q2_0 o IQ2_XS. Con 64 GB, caben las cuatro variantes habituales, aunque IQ3_S deja poco margen para otras aplicaciones. Esto no se extiende automáticamente a todos los formatos experimentales de cuatro bits.
El almacenamiento requiere más atención que el resumen de «unos 80 GB». La guía de instalación reserva 70–80 GB para el modelo, unos 6 GB adicionales para el módulo de predicción y 1 GB si se habilitan imágenes. Q2_0 puede generar una copia extra de unos 40 GB en procesadores AVX-512; AMD en Linux puede añadir unos 10 GB de ROCm. El proyecto recomienda un SSD NVMe, sobre todo para la carga inicial. Algunas variantes mayores leen expertos del SSD mientras responden y son bastante más lentas. Requisitos detallados.
La velocidad depende de la variante y de la tarea
Cuantizar significa guardar los valores del modelo con menos precisión para reducir su tamaño. No todas las variantes ofrecen el mismo equilibrio entre memoria, rapidez y calidad. Coder, además, elimina la mitad de los expertos seleccionándolos para código: el propio proyecto advierte de un rendimiento más débil fuera de ese ámbito y en idiomas distintos del inglés. Elección de modelo.
El autor publica 94 tokens por segundo con Q2_0 y 53 con IQ3_S en una RTX 5070 de 12 GB, Ryzen 5 7600 y 64 GB de RAM. Son mediciones del proyecto bajo condiciones concretas, no resultados nuestros. Leer un documento largo y generar una respuesta son operaciones diferentes. Además, las notas de la versión 0.1.39 indican que la tabla principal no se volvió a medir para esa versión. El «100 tokens por segundo» del título de Hacker News no es una velocidad universal. Tablas y condiciones, versión 0.1.39.
Qué conviene revisar antes de usarlo
La demo se presenta con IQ3_S y contexto de 128K. La captura del agente también muestra experimental-speed-projection: una opción desactivada por defecto que modifica las respuestas, no una simple mejora de velocidad. El ejemplo visual no demuestra equivalencia con el modelo original. Por defecto, Strata atiende una petición a la vez; las demás esperan. La lectura de imágenes con AMD funciona en Linux mediante CPU y todavía no en Windows. Límites y configuración, uso de la aplicación.
El motor está bajo licencia MIT, mientras que los archivos de cada modelo conservan su licencia propia; Qwen identifica Qwen Community License 1.0. No hay que interpretar «código abierto» como un permiso idéntico para todos los componentes. Los enlaces originales de instalación, modelos y licencias permiten comprobar si tu equipo y tu uso encajan antes de descargar decenas de gigabytes.
Strata ofrece una vía concreta para experimentar con programación e IA local en un PC potente. La decisión útil empieza por comprobar tu GPU, tu RAM y el formato que vas a cargar; después, por evaluar el modelo con tus propias tareas.