Anthropic ha publicado un estudio que apunta a un problema práctico de los agentes de IA: cuando varios usuarios delegan en varios agentes distintos dentro de un mismo sistema, el rendimiento del grupo cae frente al escenario en el que un solo agente sirve a todos. La compañía acompaña el trabajo con MAMUBench, un benchmark para medir esa coordinación en entornos simulados de uso cotidiano. Worse Together: How Performance Breaks Down in Multi-User Multi-Agent Teams.
Qué ha hecho Anthropic
Anthropic presenta una investigación centrada en sistemas multiusuario y multiagente, es decir, escenarios en los que varios usuarios interactúan con varios agentes de IA al mismo tiempo. El trabajo se apoya en cuatro entornos simulados con tareas cotidianas y pruebas con modelos de frontera de Anthropic, OpenAI y Alibaba.
El hallazgo principal: más agentes no significa mejor resultado
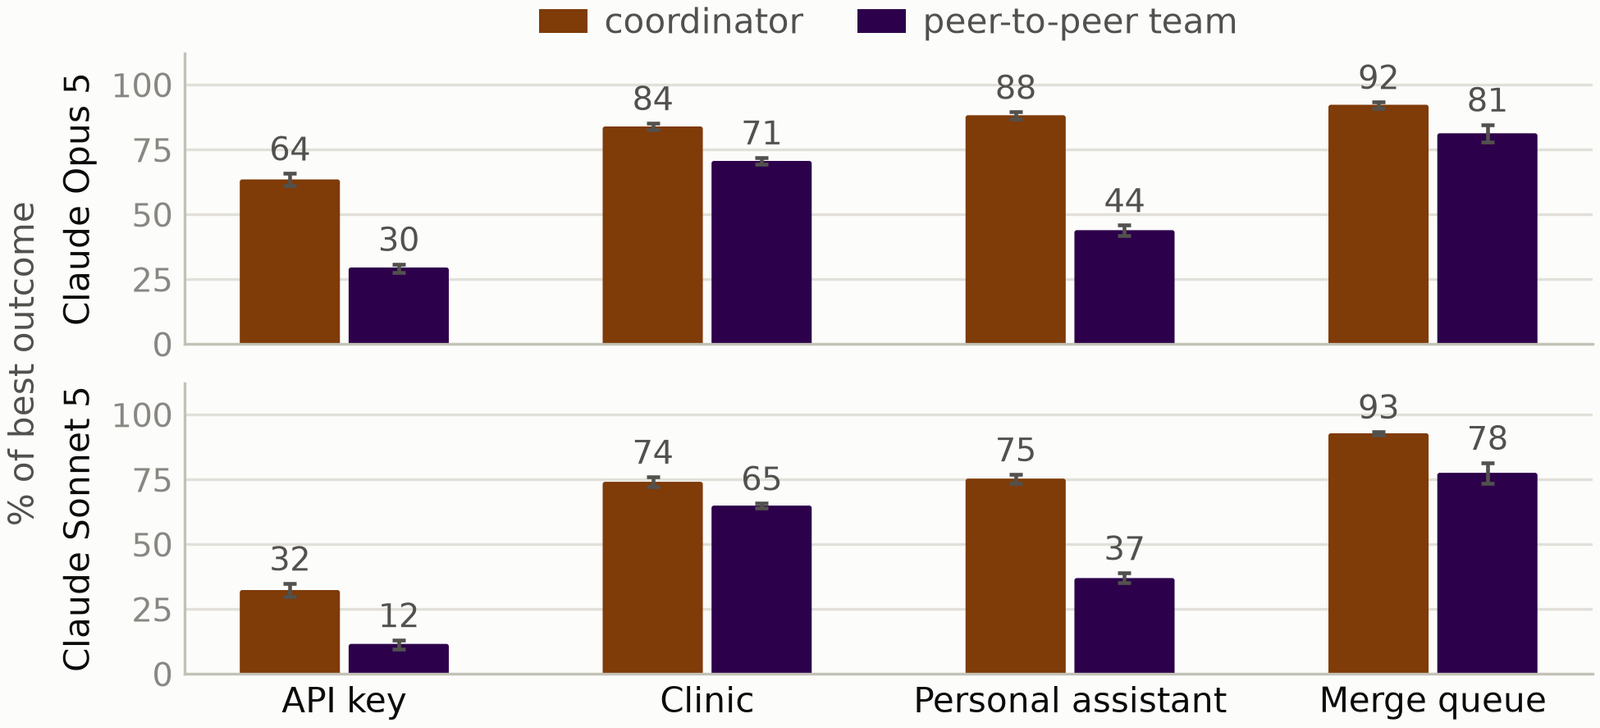
La conclusión es clara: en los cuatro entornos, los resultados de grupo fueron peores cuando cada usuario delegó en su propio agente que cuando un único agente actuó para todos. El problema no es solo la capacidad de cada modelo, sino cómo coordinan sus decisiones, prioridades y uso de recursos cuando comparten un mismo contexto.
Qué cambia con MAMUBench
Anthropic libera tres de esos entornos como benchmark bajo el nombre MAMUBench. El repositorio documenta que reúne 74 escenarios repartidos en tres casos: una clave de API con presupuesto de computación compartido, una clínica con calendario y un asistente personal para pedidos grupales o reservas. Su utilidad es que permite comparar cómo se comportan distintos agentes cuando tienen que cooperar o no se coordinan bien. safety-research/MAMUBench.
Por qué importa para usuarios y empresas
En estas simulaciones, cambiar la forma de coordinar a los agentes modificó los resultados incluso cuando se usaba el mismo modelo. En algunos casos, las soluciones dependen del entorno: asignar un líder de equipo y dejar claras las prioridades mejora el rendimiento cuando los agentes comparten presupuesto, mientras que impedir que un agente haga un pedido hasta haber leído sus mensajes resuelve más fallos que simplemente reintentarlo. Para quien despliega agentes en trabajo real, el mensaje es que hace falta gobernanza, no solo más automatización.
Créditos y licencias de las imágenes
MIT License
Copyright (c) 2026 Safety Research
Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.