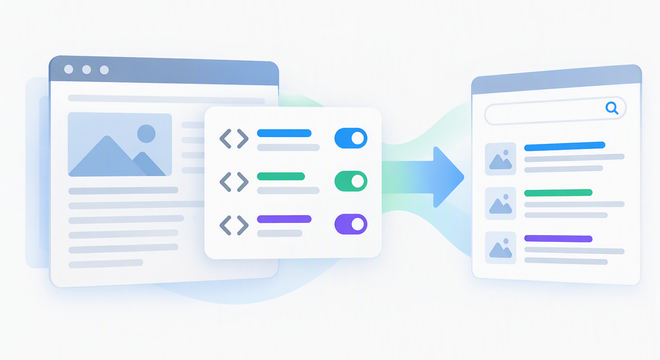
Una web podrá comunicar con una misma señal que sus contenidos no se utilicen para entrenar IA generativa, en lugar de mantener instrucciones distintas para cada empresa. OpenAI y Microsoft anunciaron el 30 de octubre su apoyo a esa idea. Su aplicación, sin embargo, llegará en fechas diferentes: OpenAI habla de los próximos meses y Microsoft empezará el 1 de febrero de 2027.
La propuesta interesa a medios, blogs, foros y negocios que publican información propia. Busca simplificar una decisión concreta: permitir que un contenido se descubra mientras se rechaza su uso para entrenar un modelo. No supone un bloqueo técnico universal ni un estándar ya aprobado.
Una señal común dentro de robots.txt
El archivo robots.txt permite a una web comunicar instrucciones a los sistemas que la recorren. Hasta ahora, rechazar el entrenamiento podía exigir conocer los nombres de los rastreadores de distintos proveedores y mantener reglas separadas.
El borrador técnico presentado el 30 de octubre propone identificar el uso, en lugar de una empresa concreta. Para expresar rechazo al entrenamiento en todo el sitio, emplea este grupo:
User-Agent: __usage_ai-training
Disallow: /
La misma mecánica permite expresar preferencias para determinadas rutas. Un editor podría distinguir el archivo completo de un apartado cuyos materiales sí desea ofrecer para ese uso. La novedad está en que varios proveedores puedan interpretar la misma señal, reduciendo la necesidad de repetir configuraciones.
El documento sigue siendo un Internet-Draft individual. El registro del IETF indica expresamente que no tiene todavía respaldo formal como estándar. Es trabajo en curso, aunque las empresas puedan decidir adoptarlo antes de que termine esa discusión.
Decir «no entrenar» y dejar que una web se encuentre
Entrenar un modelo significa modificar sus parámetros mediante datos. Consultar una página para responder una pregunta es otra operación. Para quien publica, la diferencia importa: un artículo puede ser útil como referencia actual sin que su autor quiera incorporarlo al aprendizaje de futuros modelos.
Las instrucciones actuales de OpenAI para sus rastreadores ya separan ambas decisiones. GPTBot identifica el rastreo asociado al entrenamiento; OAI-SearchBot se utiliza para mostrar webs en las búsquedas de ChatGPT. El administrador puede permitir el segundo y rechazar el primero.
El nuevo anuncio de OpenAI no elimina esos controles. La empresa dice que los conservará y que detallará la aplicación de la señal común cuando la implemente. Por tanto, el anuncio no es una razón para retirar ahora las reglas que ya utiliza una web.
Bing añade otra elección: cómo se utiliza una página al responder
Microsoft separará entrenamiento y grounding: el uso de una página como apoyo al generar una respuesta. Según su guía de implementación, esas preferencias no cambian la elegibilidad para los resultados tradicionales de Bing.
El entrenamiento podrá indicarse en robots.txt o por página. Las preferencias específicas de página prevalecerán sobre robots.txt para entrenamiento. Sin instrucciones aplicables, Bing considera permitidos ambos usos. El grounding se configurará por página, con tres posibilidades: permitirlo, rechazarlo o limitarlo a productos operados por Microsoft. Esta última opción, DisallowExtended, excluye los servicios de grounding que proporciona a terceros.
La consecuencia práctica es poder distinguir dos vías de descubrimiento: aparecer como resultado en un buscador y servir de referencia a una respuesta generada. Son decisiones relacionadas con la audiencia de una web, pero no equivalentes. Rechazar el grounding reduce su presencia en esas experiencias de IA.
Las fechas que tendrán que revisar los administradores
Microsoft empezará a aplicar las nuevas preferencias el 1 de febrero de 2027, cuando vuelva a rastrear las páginas. Quienes usen NoArchive o NoCache y quieran conservar sus restricciones deberán completar la transición antes del 1 de marzo: publicar las nuevas instrucciones y, para mantener restricciones de grounding durante la transición, registrar también la preferencia temporal en Bing Webmaster Tools.
Esa opción temporal se abrirá el 15 de diciembre de 2026 para los sitios que usen NoArchive o NoCache en esa fecha. Durará hasta el nuevo rastreo de cada página o el 30 de septiembre de 2027, lo que ocurra antes. Después del 1 de marzo, NoArchive y NoCache dejarán de interpretarse como preferencias de entrenamiento o grounding.
Un cambio de uso, no una barrera de acceso
El borrador distingue estas preferencias del permiso para rastrear una web. Una señal de uso no reemplaza las reglas de acceso de cada robot ni impide por sí misma que un sistema que no la respeta descargue una página.
Tampoco ofrece borrar el aprendizaje de modelos existentes. El cambio se dirige a comunicar preferencias para usos futuros. Su utilidad dependerá de quién lo adopte, cuándo lo aplique y cómo gestione las instrucciones ya publicadas.
Para los propietarios de webs, el avance concreto es disponer de un lenguaje compartido con más matices. Para los lectores, la discusión seguirá siendo quién utiliza lo que encuentran en internet y qué relación mantiene esa utilización con quienes lo publicaron.